


Nehmen wir an, Ihr Unternehmen fertigt Hydraulikkomponenten und betreibt mit vier Entwicklern ein Bestellportal samt Schnittstellen zum ERP. Seit einigen Monaten nutzt das Team einen Coding Agent. Kleine Änderungen gehen schneller, bei größeren Aufgaben verliert der Agent den Faden, und niemand weiß so recht, wie viel Verantwortung man ihm übertragen darf.
Bei großen Softwarehäusern ist diese Frage bereits weiter beantwortet. Laut Google-Chef Sundar Pichai werden 75 % des neuen Codes bei Google von AI erzeugt und anschließend von Entwicklern geprüft (April 2026). Spotify-Co-CEO Gustav Söderström sagte im Februar 2026 im Earnings Call, die besten Entwickler des Unternehmens hätten seit Dezember keine einzige Codezeile mehr geschrieben. Sie steuern stattdessen Claude Code über ein internes System namens Honk.
Andrej Karpathy hat für diese Arbeitsweise im Februar 2026 den Begriff Agentic Engineering vorgeschlagen. Agentic Engineering ist die Disziplin, AI Agents so anzuleiten, auszustatten und einzubetten, dass sie Software weitgehend selbstständig schreiben, während Menschen Ziele setzen und Ergebnisse prüfen. Dahinter stehen fünf Begriffe, die aufeinander aufbauen.
Fünf Ebenen, von der Anweisung bis zur Fabrik
Die unteren Ebenen betreffen jede einzelne Anfrage an ein Modell, die oberen das System, in dem viele Agenten ohne ständige Aufsicht arbeiten. Wer Informatik studiert hat, erkennt alte Bekannte wie Feedbackschleifen und verteilte Systeme. Neu ist, dass ein Sprachmodell darin die Arbeit erledigt.
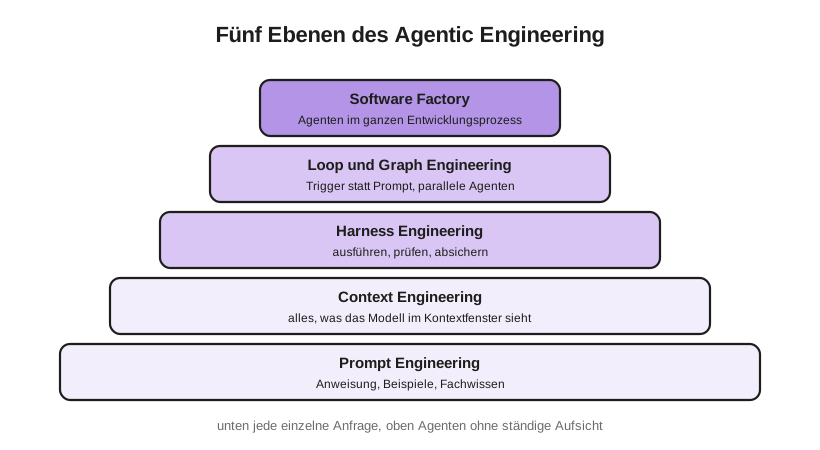
Prompt Engineering: Fachwissen schlägt Modellwahl
Prompt Engineering formuliert die Anweisung, der das Modell folgt, etwa „Antworte nur auf Basis der beigefügten Schnittstellendokumentation“. Auch das stärkste Modell liefert wenig, wenn unklar bleibt, was es tun soll. Wer gut anleiten will, braucht deshalb vor allem Fachwissen über die Aufgabe. Programmierkenntnisse helfen, sind aber keine Voraussetzung. Manche Entwickler diktieren ihre Anweisungen minutenlang per Spracheingabe, und große Modelle verstehen auch solche ungeordneten Erklärungen gut.
Kleinere Modelle, die lokal oder auf einem Smartphone laufen, brauchen mehr Hilfe. Bewährt hat sich Few-Shot Prompting: Sie geben einige Beispiele aus Frage und gewünschter Antwort mit, und das Modell übernimmt das Muster. Bei Chain of Thought, also vorgemachten Denkschritten, lohnt ein eigener Test. Die Originalstudie von Wei et al. aus dem Jahr 2022 beschreibt diese Fähigkeit als etwas, das erst in ausreichend großen Modellen entsteht.
Context Engineering: alles, was das Modell sieht
Das Modell liest weit mehr als Ihre Anweisung. Im Context Window (Kontextfenster) liegen System Prompt, Tool-Definitionen, MCP-Server, Skills, Dokumente aus der Retrieval Augmented Generation (RAG) und bei Coding Agents große Teile der Codebasis. Die Qualität der Antworten sinkt, lange bevor die beworbene Grenze erreicht ist.
Context Engineering hält dieses Fenster schlank: Ein langer Verlauf wird zusammengefasst und als frischer Prompt weitergegeben, Recherchen in Bibliotheken oder Dokumentation übernehmen Subagents mit eigenem Kontext. Wie ein Kontext kippt, zeigt unser Beitrag zum Context Engineering.
Harness Engineering: ausführen, prüfen, absichern
Ein Modell mit gutem Kontext liefert eine plausible Antwort. Ob der geänderte Code auch funktioniert, weiß es damit noch nicht. Die Harness ist alles rund um das Modell, was es handeln und das Ergebnis prüfen lässt: die Laufzeitumgebung, die Dateien bearbeitet und Befehle ausführt, das Verwalten des Kontextfensters über lange Sitzungen, das Koordinieren von Subagents und eine Sandbox, damit der Agent nicht beliebig auf Ihrem Rechner arbeitet.
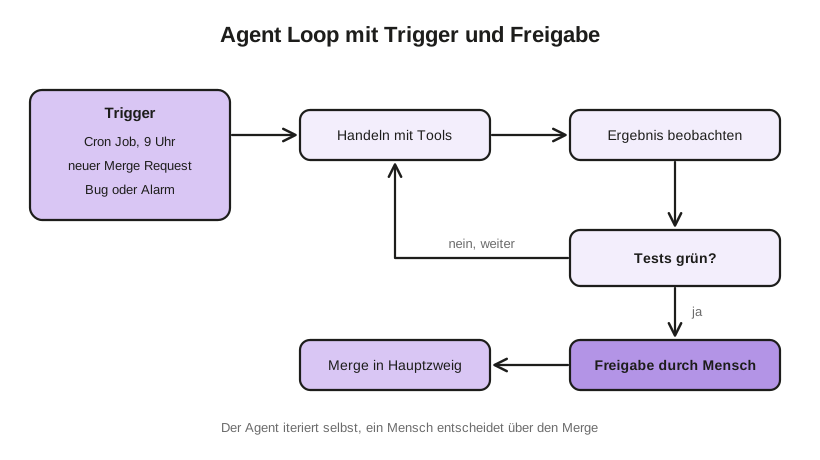
Den größten Nutzen bringt das Feedback. Die Harness meldet dem Agenten, ob die Testsuite nach seiner Änderung grün ist oder ob beim Zusammenführen ein Merge-Konflikt entstanden ist. So iteriert der Agent selbst, statt für jeden Schritt eine Freigabe einzuholen. Viele Harnesses binden dafür bestehende CI-Pipelines und Monitoring an.
OpenAI beschreibt diesen Ansatz im Beitrag „Harness engineering: leveraging Codex in an agent-first world“ vom Februar 2026. Laut InfoQ entstand dort in fünf Monaten ein internes Produkt mit rund einer Million Zeilen Code, ohne manuell geschriebenen Quellcode. Die Entwickler gestalteten Umgebungen, beschrieben Ziele und gaben strukturiertes Feedback. Wie weit eine Harness mit besseren Modellen wieder schrumpfen kann, beschreibt unser Beitrag zu Subagents und Skills.
Loop Engineering: ein Trigger startet den Agenten
Im Kern ist ein AI Agent eine Schleife. Er bekommt ein Ziel, handelt mit Tools, beobachtet das Ergebnis und entscheidet, ob er fertig ist oder weitermacht. Loop Engineering ersetzt den Menschen, der diese Schleife per Prompt anstößt, durch einen Trigger. Das kann ein Cron Job sein, der jeden Morgen um 9 Uhr läuft, ein neuer Merge Request, ein gemeldeter Bug oder ein Alarm aus dem Monitoring.
Für das Hydraulik-Portal könnte das so aussehen: Jede Nacht arbeitet ein Agent die Issues mit dem Label „klein“ ab, und jeder neue Merge Request startet einen Agenten, der Tests ergänzt. Ein Mensch gibt die Änderungen frei, bevor sie in den Hauptzweig gelangen. Diese Freigabe kann nach dem Handeln des Agenten liegen oder erst nach der Prüfung seines Ergebnisses.
Graph Engineering: mehrere Agenten, ein Ziel
Graph Engineering verbindet mehrere solcher Schleifen. Ein Agent analysiert, wie das Repository aufgebaut ist, ein zweiter recherchiert parallel die Dokumentation der ERP-Schnittstelle, und beide übergeben ihre Ergebnisse an einen dritten, der implementiert. Aus der Schleife wird ein verzweigter Ablauf.
Jeder zusätzliche Agent verbraucht Tokens. Anthropic beziffert im Juni 2025 den Verbrauch seines Multi-Agent-Recherchesystems auf etwa das 15-Fache der Tokens eines Chats. Parallele Agenten lohnen sich deshalb vor allem dann, wenn die Teilaufgaben unabhängig voneinander sind.
Software Factory: Agenten im ganzen Entwicklungsprozess
Die oberste Ebene automatisiert den gesamten Software Development Lifecycle. Statt eines Allzweck-Agenten übernehmen spezialisierte Agenten einzelne Aufgaben: Tickets aufbereiten, implementieren, testen. Jeder davon braucht drei Dinge:
- Isolation: Er arbeitet in einem Container oder einer Sandbox.
- Identität: Es ist festgelegt, wer er ist und worauf er in Git oder in der Cloud zugreifen darf.
- Observability: Was er um drei Uhr früh getan hat, lässt sich am Morgen lückenlos nachverfolgen.
Immer mehr Teams bauen solche Fabriken auf. Für vier Entwickler mit einem Bestellportal ist das meist zu viel Aufwand.
Welche Ebene Sie wirklich brauchen
Einzelentwickler und kleine Teams kommen ohne Software Factory aus. Prompt, Kontext und Harness betreffen dagegen alle, die mit AI Agents arbeiten, auch Designer und Führungskräfte. Ein sinnvoller Einstieg ist eine Harness, die Tests und CI zuverlässig zurückmeldet. Danach folgt eine erste Schleife mit einem einzigen Trigger und klarer Freigabe durch einen Menschen. Parallele Agenten und eigene Agentenidentitäten kommen erst, wenn diese Schleife stabil läuft und Sie wissen, was ein Durchlauf kostet.
Häufige Fragen zum Agentic Engineering
Was ist der Unterschied zwischen Vibe Coding und Agentic Engineering? Beim Vibe Coding nimmt man generierten Code an, ohne ihn genau zu prüfen. Agentic Engineering setzt auf Tests, Feedbackschleifen und menschliche Freigaben, damit Agenten verlässlich produktiven Code liefern.
Was gehört zu einer Agent Harness? Laufzeitumgebung, Tools, Sandbox, Kontextverwaltung und Rückmeldungen aus Tests und CI. Erst dadurch kann ein Agent prüfen, ob seine Änderung funktioniert.
Brauche ich Programmierkenntnisse für Agentic Engineering? Für Prompts und Kontext zählt vor allem Fachwissen über die Aufgabe. Wer Harness und Schleifen aufbaut, braucht dagegen Erfahrung mit Entwicklungswerkzeugen wie Git und CI-Pipelines.
Interessiert? In einem kostenlosen Beratungsgespräch besprechen wir Ihre individuellem Anforderungen an den Einsatz künstlicher Intelligenz! Beratungstermin vereinbaren