


Vor wenigen Jahren fasste das Context Window (Kontextfenster) eines Sprachmodells ein paar tausend Token, also ungefähr einen längeren Zeitungsartikel. Heute liegen die Grenzen bei einer Million Token und darüber. Wer AI Agents baut, könnte daraus eine einfache Rechnung ableiten: mehr Platz für Anweisungen, Dokumente und Werkzeugausgaben, folglich bessere Ergebnisse bei langen Aufgaben.
Die Messungen sagen etwas anderes. Das Forschungsteam von Chroma hat im Juli 2025 18 aktuelle Modelle untersucht, darunter GPT-4.1, Claude 4 und Gemini 2.5. Die Aufgaben blieben gleich, nur die Eingabe wurde länger. Mit jedem zusätzlichen Token wurden die Antworten weniger zuverlässig, und zwar auch bei Aufgaben, die ein Mensch als trivial bezeichnen würde. Für dieses Phänomen hat sich der Begriff Context Rot eingebürgert, auf Deutsch etwa Kontextverfall.
Hier setzt Context Engineering an. Gemeint ist die bewusste Entscheidung, was in jedem einzelnen Schritt eines Agentenlaufs im Kontextfenster steht und was nicht. Prompt Engineering formuliert eine Anweisung. Context Engineering bewirtschaftet den gesamten Arbeitsspeicher des Agenten, oft über Stunden hinweg.
Was in einem Kontextfenster tatsächlich liegt
Nehmen wir einen konkreten Fall. Ein Agent soll 40.000 Kundendatensätze aus einem alten CRM in ein neues übertragen: Kontakte, Firmen, Gesprächsnotizen, Zuständigkeiten. Eine Aufgabe für mehrere Stunden, mit vielen Einzelschritten.
Ganz vorne im Fenster steht der System Prompt mit den Grundregeln, nach denen der Agent arbeitet. Dahinter kommt die eigentliche Aufgabe, meist nur zwei oder drei Zeilen. Dann folgen Projektanweisungen, etwa eine Datei, die erklärt, wie die Felder der beiden Systeme zueinander passen. Anschließend die Tool-Definitionen, also eine Beschreibung jedes Werkzeugs, das der Agent aufrufen darf.
Ab hier wird das Fenster zum Protokoll. Jeder Schritt, den der Agent setzt, landet im Nachrichtenverlauf. Und jeder Schritt bringt Ergebnisse mit: Datenbankauszüge, API-Antworten, Fehlermeldungen, Schema-Dumps. Dieser Block ist nach einer Stunde Laufzeit mit Abstand der größte.
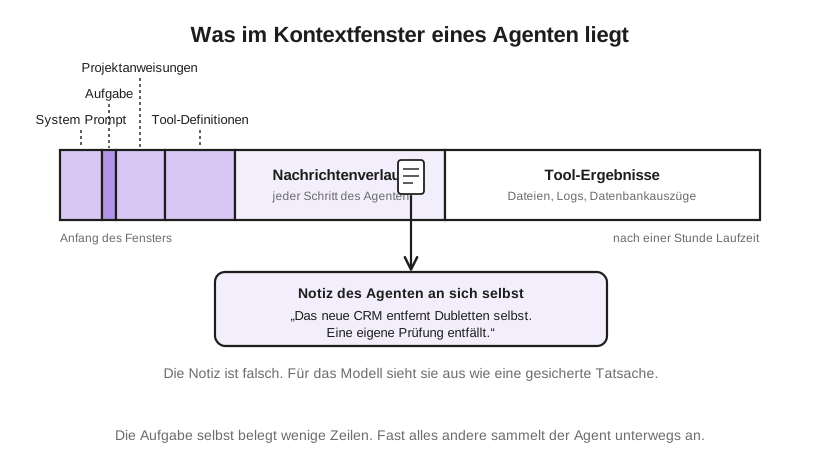
Irgendwo im Verlauf steckt außerdem eine Notiz, die der Agent sich selbst geschrieben hat: „Das neue CRM führt doppelte Kontakte beim Import automatisch zusammen. Eine eigene Dublettenprüfung entfällt.“ Merken Sie sich diesen Satz, er kommt noch einmal vor.
Das Aufmerksamkeitsbudget
Warum ist ein volles Fenster überhaupt ein Problem? Ein Sprachmodell schlägt nicht nach wie eine Datenbank, die eine Zeile anhand ihres Schlüssels findet. Es verteilt bei jedem Rechenschritt eine begrenzte Menge Aufmerksamkeit über sämtliche Token im Fenster. Anthropic nennt das in seinem Leitfaden zum Context Engineering ein Attention Budget.
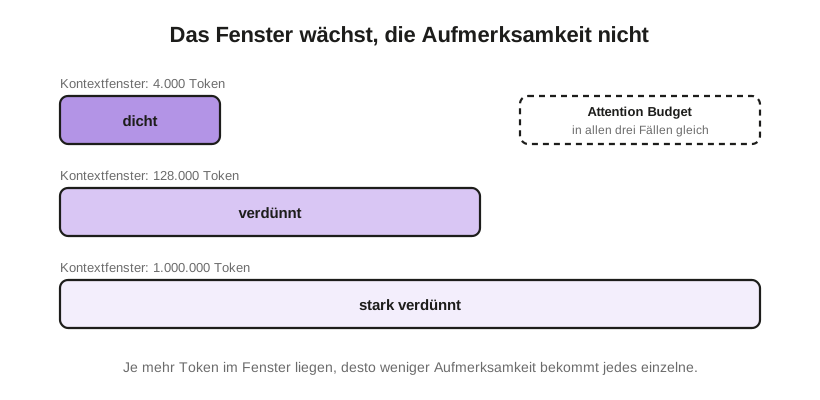
Das Fenster mag eine Million Token fassen. Das Budget, das darauf verteilt wird, wächst nicht mit. Jedes Token, das Sie hineinlegen, verdünnt die Aufmerksamkeit für alle anderen. Eine wichtige Anweisung auf Seite drei konkurriert mit einem Schema-Dump auf Seite achtzig.
Vier Arten, wie ein Kontext kippt
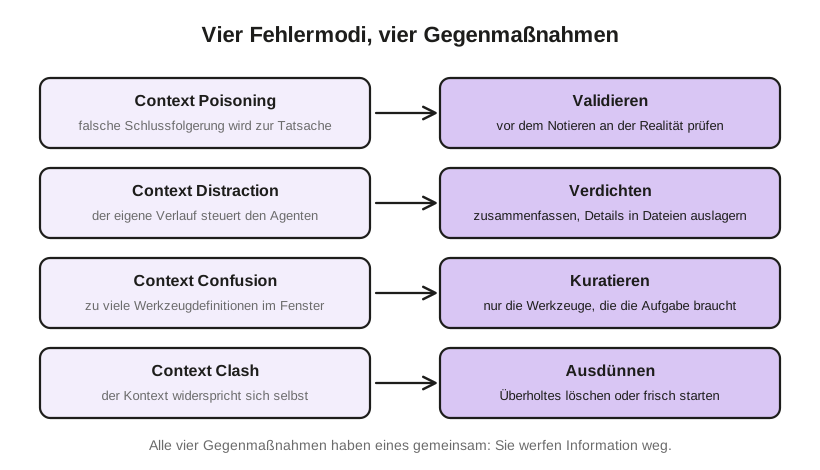
Drew Breunig hat im Juni 2025 vier Fehlermodi beschrieben, die sich seither als Vokabular durchgesetzt haben. Zu jedem gibt es eine passende Gegenmaßnahme, und alle vier haben eine Gemeinsamkeit: Sie werfen Information weg.
Context Poisoning: eine falsche Notiz wird zur Tatsache
Zurück zu unserer Notiz. Sie ist falsch. Der Agent hat die Dokumentation des neuen CRM nur überflogen und eine Einschränkung übersehen: Zusammengeführt werden ausschließlich Kontakte mit identischer E-Mail-Adresse. Alle anderen Dubletten bleiben stehen.
Für das Modell sieht die eigene Notiz aber aus wie eine gesicherte Tatsache. Also überspringt der Agent bei jedem weiteren Datensatz die Prüfung, Stunde um Stunde, und das neue System füllt sich mit doppelten Einträgen. Ein einzelner Fehler hat sich im Kontext festgesetzt und vergiftet jeden folgenden Schritt.
Gegenmaßnahme: Validieren. Bevor eine Schlussfolgerung in den Kontext geschrieben wird, muss sie gegen etwas Reales geprüft werden. Zwei Testkontakte mit unterschiedlicher Schreibweise importieren, nachsehen, ob sie zusammengeführt wurden. Ein Aufruf hätte gereicht, und die Notiz wäre nie entstanden.
Context Distraction: der Verlauf übernimmt das Steuer
Ein Sprachmodell setzt Muster fort. Wenn der Kontext eine Stunde eigener Handlungen enthält, ist dieser Verlauf das stärkste Muster weit und breit, stärker als das Vorgehen, das das Modell im Training gelernt hat. Statt zu fragen, was die Aufgabe als Nächstes braucht, macht der Agent mehr von dem, was er ohnehin schon getan hat. Er prüft Tabellen erneut, die längst übertragen sind, oder dreht sich in Schleifen aus Lesen und Nachsehen.
Gegenmaßnahme: Verdichten. Wird der Verlauf lang, fasst der Agent ihn zusammen, verwirft das vollständige Protokoll und arbeitet mit der Zusammenfassung weiter. Dabei geht allerdings etwas verloren. Jede Zusammenfassung lässt Details weg, und eine Zusammenfassung der Zusammenfassung driftet wie die Fotokopie einer Fotokopie.
Besser ist es, Details gar nicht erst im Fenster zu halten. Feldzuordnungen, Zwischenstände und Fehlerlisten gehören in Dateien, aus denen der Agent sie bei Bedarf holt. Das gleiche Prinzip steht hinter dem Ansatz, den wir in unserem Beitrag zu Chunkless RAG beschrieben haben: Die Information bleibt vollständig erhalten, nur ins Fenster kommt sie erst, wenn sie gebraucht wird.
Context Confusion: zu viele Werkzeuge
Unser Migrationsagent ist gut vernetzt. Er hat Zugriff auf die Versionsverwaltung, eine Datenbankkonsole, das Ticketsystem, den Kalender und das Mailpostfach. Jede dieser Fähigkeiten steht als Tool-Definition im Fenster, ob sie im Lauf verwendet wird oder nicht. Und je mehr Werkzeuge zur Auswahl stehen, desto häufiger greift das Modell zum falschen oder beschreibt den Aufruf fehlerhaft.
Wie stark dieser Effekt sein kann, zeigt eine Studie, die Breunig anführt. Ein quantisiertes Llama 3.1 mit 8 Milliarden Parametern scheiterte an einer Aufgabe aus dem GeoEngine-Benchmark, solange ihm 46 Werkzeuge angeboten wurden. Mit 19 Werkzeugen löste es dieselbe Aufgabe.
Gegenmaßnahme: Kuratieren. Für eine CRM-Migration braucht niemand 46 Werkzeuge. Der Agent bekommt die Handvoll, die zur Aufgabe passt. Alles Weitere kann er bei Bedarf nachladen, etwa über eine Werkzeugsuche, die erst die Beschreibung ins Fenster holt, wenn sie gebraucht wird.
Context Clash: der Kontext widerspricht sich selbst
Irgendwann fällt dem Agenten auf, dass im neuen System Dubletten liegen. Er zieht die richtige Schlussfolgerung und schreibt eine Korrektur in den Verlauf. Jetzt stehen aber beide Versionen im Fenster, die alte Notiz und die neue. Bei jedem Schritt muss das Modell neu entscheiden, welcher es glaubt. Manchmal gewinnt die falsche.
Gegenmaßnahme: Ausdünnen. Überholte Information wird gelöscht statt stehen gelassen. Die alte Notiz hätte verschwinden müssen, als die Korrektur geschrieben wurde. Wer gründlicher vorgehen will, startet ein frisches Fenster und gibt dem Agenten nur den aktuellen, bereinigten Stand der Aufgabe mit.
Was das für Ihre eigenen Agenten bedeutet
Die vier Fehlermodi treten nicht nur bei stundenlangen Migrationsläufen auf. Ein Kundenservice-Agent, der ein Gespräch über 60 Nachrichten führt, oder ein Rechercheagent, der 30 Dokumente nacheinander liest, hat dieselben Probleme im Kleinen. Bei lokal betriebenen Modellen mit kleineren Fenstern zeigen sie sich früher und deutlicher.
Daraus ergeben sich ein paar Grundsätze für den Bau von AI Agents:
- Das Fenster ist ein Budget, kein Lager. Alles, was hineinkommt, muss den Platz wert sein.
- Zwischenergebnisse gehören in Dateien. Im Verlauf steht dann nur noch, wo etwas liegt.
- Werkzeuge pro Aufgabe zuschneiden. Ein Agent für Rechnungsprüfung braucht keinen Kalenderzugriff.
- Schlussfolgerungen prüfen, bevor sie notiert werden. Ein Testaufruf dauert Sekunden und erspart im schlechtesten Fall einen kompletten Neustart.
- Lange Läufe in Etappen teilen. Jede Etappe beginnt mit einem sauberen Fenster und einem knappen Stand der Dinge.
Je länger die Aufgabe, desto wichtiger wird, was gerade nicht im Fenster steht.
Häufige Fragen zum Context Engineering
Worin unterscheidet sich Context Engineering von Prompt Engineering? Prompt Engineering optimiert eine einzelne Anweisung an das Modell. Context Engineering steuert den gesamten Inhalt des Kontextfensters über alle Schritte eines Agentenlaufs: Anweisungen, Werkzeuge, Verlauf, Zwischenergebnisse und ausgelagerte Dateien.
Lohnt sich ein Modell mit größerem Kontextfenster dann überhaupt? Ja, als Reserve. Ein großes Fenster verzeiht einzelne Ausreißer, etwa ein langes Dokument, das vollständig gelesen werden muss. Wer es routinemäßig füllt, bekommt die oben beschriebenen Effekte.
Gilt das auch für Chatbots und RAG-Systeme? Ja. Ein Chatbot mit langer Gesprächshistorie leidet unter Context Distraction, ein RAG-System, das zu viele Treffer ins Fenster lädt, unter Context Confusion. Die Gegenmaßnahmen sind dieselben.
Interessiert? In einem kostenlosen Beratungsgespräch besprechen wir Ihre individuellem Anforderungen an den Einsatz künstlicher Intelligenz! Beratungstermin vereinbaren