


Ein kurzes Rechenbeispiel vorweg. Die größten aktuellen Sprachmodelle haben mehr als eine Billion Parameter. Bei 16 Bit pro Parameter sind das rund zwei Terabyte, nur für die Gewichte. Die größte GPU, die Sie derzeit kaufen können, hat 288 GB Speicher, das geht sich nicht einmal annähernd aus.
Trotzdem antworten ChatGPT, Claude oder Gemini Millionen Menschen gleichzeitig, meist in wenigen Sekunden. Hinter keinem dieser Dienste steht ein einzelner Superrechner. Die Modelle laufen auf Verbünden aus Dutzenden, teils Hunderten GPUs, die eng zusammenarbeiten. Das Verfahren dahinter heißt Distributed Inference, also verteilte Inferenz.
Für Unternehmen, die KI auf eigener Hardware betreiben, ist das Thema näher, als es zunächst klingt. Spätestens wenn ein 70-Milliarden-Modell im Haus laufen soll und mehr als eine Handvoll Kolleginnen und Kollegen damit arbeiten, stellt sich dieselbe Frage im Kleinen.
Drei Engpässe, die gleichzeitig gelöst werden müssen
Wer ein Modell produktiv betreibt, muss drei Dinge gleichzeitig in den Griff bekommen.
Die Gewichte. Ein Modell besteht aus vielen Schichten (Layers), und in diesen Schichten steckt sein gesamtes gelerntes Wissen. Bevor auch nur ein Wort erzeugt wird, müssen alle Gewichte im GPU-Speicher liegen. Ein Llama-Modell mit 70 Milliarden Parametern braucht in voller 16-Bit-Präzision etwa 140 GB.
Der KV-Cache. Während eines Gesprächs merkt sich das Modell, was bisher gesagt wurde. Diese Zwischenergebnisse landen im sogenannten KV-Cache, und der wächst mit jedem Token. Beim erwähnten 70B-Modell sind das grob 0,3 MB pro Token, was zunächst harmlos wirkt. Bei 32 parallelen Nutzern mit je 8.000 Token Kontext sind es aber bereits über 80 GB, zusätzlich zu den Gewichten.
Der Durchsatz. Jede Anfrage braucht eine gewisse Rechenzeit auf der GPU. Kommen mehr Anfragen herein, als abgearbeitet werden können, bildet sich eine Warteschlange, und alle warten länger.
Eine einzelne GPU stößt meist an mindestens eine dieser Grenzen. Die folgenden Verfahren setzen jeweils an einer davon an.
Datenparallelität: das Modell einfach kopieren
Der einfachste Fall: Modell und KV-Cache passen gut auf eine GPU, aber es sind zu viele Nutzer. Dann legen Sie mehrere vollständige Kopien des Modells auf mehrere GPUs und verteilen die Anfragen darauf.
Das nennt sich Data Parallelism. Die Kopien müssen nicht miteinander reden. Ein vorgeschalteter Router entscheidet nur, welche Anfrage wohin geht, etwa nach aktueller Auslastung oder danach, welche Kopie den passenden Kontext schon im Cache hat.
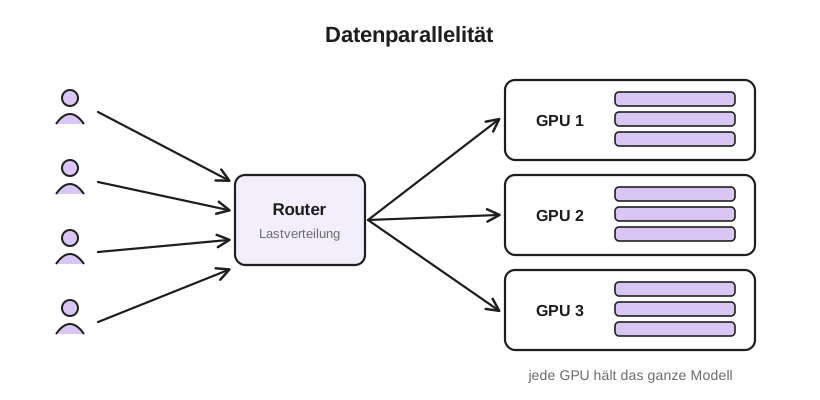
Für viele mittelständische Szenarien ist das bereits die Lösung. Zwei Server mit je einem kleineren, quantisierten Modell bedienen deutlich mehr Mitarbeitende als einer, und der Betrieb bleibt überschaubar.
Pipeline-Parallelität: das Modell nach Schichten aufteilen
Schwieriger wird es, wenn das Modell selbst zu groß ist. Hier hilft ein Blick darauf, wie Inferenz abläuft. Die Eingabe wandert Schicht für Schicht durch das Netz, ähnlich wie ein Werkstück durch eine Fertigungsstraße.
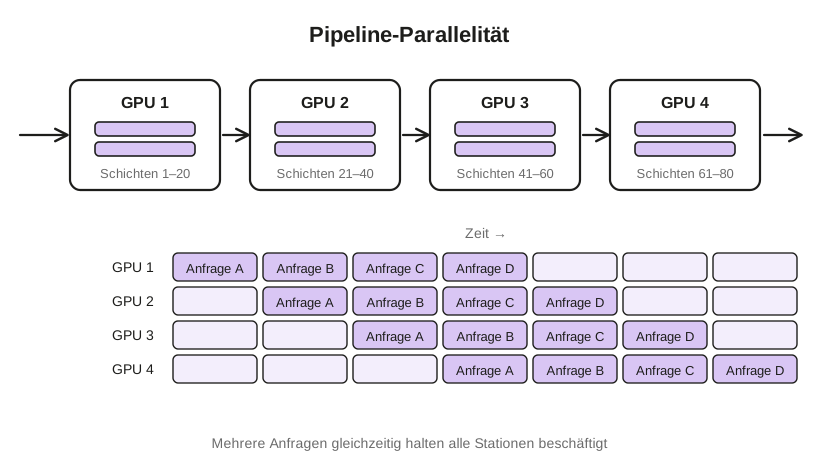
Bei Pipeline Parallelism bekommt jede GPU einen Abschnitt dieser Straße. Die erste hält etwa die Schichten 1 bis 20, die zweite 21 bis 40 und so weiter. Jede GPU muss nur so viel speichern, wie in ihren Speicher passt.
Der Haken liegt im Leerlauf. Schicken Sie nur eine einzige Anfrage durch, arbeitet immer nur eine Station, und die anderen warten. Sinnvoll wird das Verfahren erst, wenn ständig mehrere Anfragen gleichzeitig unterwegs sind und jede Station etwas zu tun hat.
Tensor-Parallelität: jede Schicht in Scheiben schneiden
Pipeline-Parallelität teilt das Modell sozusagen vertikal. Tensor Parallelism schneidet horizontal: Jede einzelne Schicht wird auf mehrere GPUs aufgeteilt. Jede GPU rechnet ihren Teil der Matrixmultiplikation, dann tauschen alle ihre Teilergebnisse aus und setzen sie zusammen, bei jeder Schicht aufs Neue.
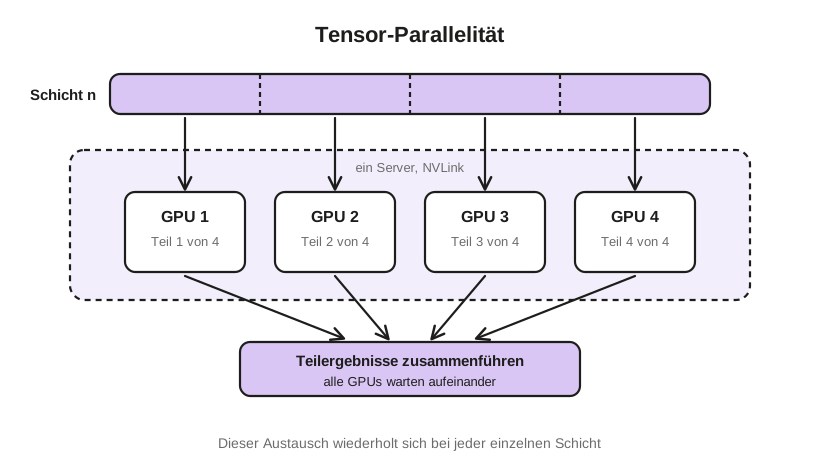
Dieser Austausch (eine sogenannte Collective Operation) blockiert. Keine GPU kann weitermachen, bevor alle fertig sind. Deshalb funktioniert Tensor-Parallelität nur mit sehr schnellen Verbindungen zwischen den Karten, typischerweise NVLink innerhalb eines Servers. Über ein normales Netzwerk verteilt wird aus der Optimierung schnell eine Bremse.
Das sehen wir auch bei Kunden, die zwei Consumer-GPUs über PCIe zusammenschalten und dann enttäuscht sind. Das Modell passt zwar in den gemeinsamen Speicher, die Antwortgeschwindigkeit bleibt aber hinter den Erwartungen zurück.
Expertenparallelität für Mixture-of-Experts-Modelle
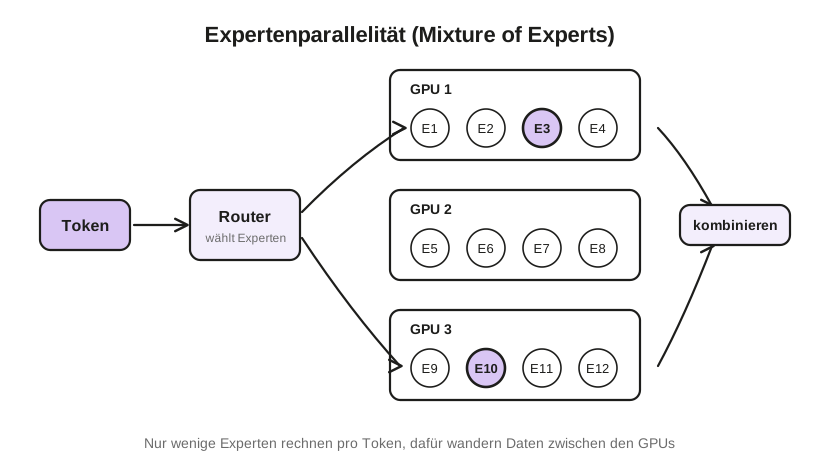
Viele aktuelle Spitzenmodelle, darunter DeepSeek, Qwen und Mistral, sind als Mixture of Experts (MoE) gebaut. Statt eines großen Blocks, der für jede Eingabe vollständig durchgerechnet wird, enthalten sie viele kleinere Teilnetze, die Experten. Ein Router wählt pro Token aus, welche davon zum Einsatz kommen. Bei DeepSeek-V3 sind das zum Beispiel 8 von 256.
Pro Token wird damit nur ein kleiner Teil des Modells gerechnet. Trotzdem sind solche Modelle insgesamt riesig, denn alle Experten müssen ja irgendwo liegen.
Expert Parallelism verteilt die Experten auf verschiedene GPUs. Jede Karte hält nur ihre Auswahl. Der Preis dafür ist Netzwerkverkehr: Jedes Token muss zu den GPUs geschickt werden, auf denen seine Experten liegen, und die Ergebnisse müssen danach wieder eingesammelt werden. Man spart also Rechenzeit und bezahlt dafür mit Netzwerklast.
Prefill und Decode trennen
Das letzte Verfahren setzt an einer Eigenheit der Inferenz an, die oft übersehen wird. Eine Anfrage durchläuft zwei sehr unterschiedliche Phasen.
Im Prefill liest das Modell Ihre Eingabe ein. Alle Token des Prompts werden parallel verarbeitet, und dabei entsteht der KV-Cache. Diese Phase ist rechenintensiv. Wie schnell sie läuft, hängt an der reinen Rechenleistung der GPU.
Im Decode schreibt das Modell die Antwort, Token für Token. Für jedes neue Token muss der komplette KV-Cache aus dem Speicher gelesen werden. Die GPU wartet in dieser Phase vor allem auf Daten, deshalb bestimmt die Speicherbandbreite das Tempo.
Laufen beide Phasen auf denselben GPUs, kommen sie sich in die Quere. Der wachsende Speicherbedarf der Decode-Phase drängt die Prefill-Phase zurück, lange Prompts bremsen wiederum laufende Antworten. Bei der Prefill-Decode-Disaggregation bekommt jede Phase einen eigenen GPU-Pool, der auf ihren jeweiligen Engpass zugeschnitten ist.
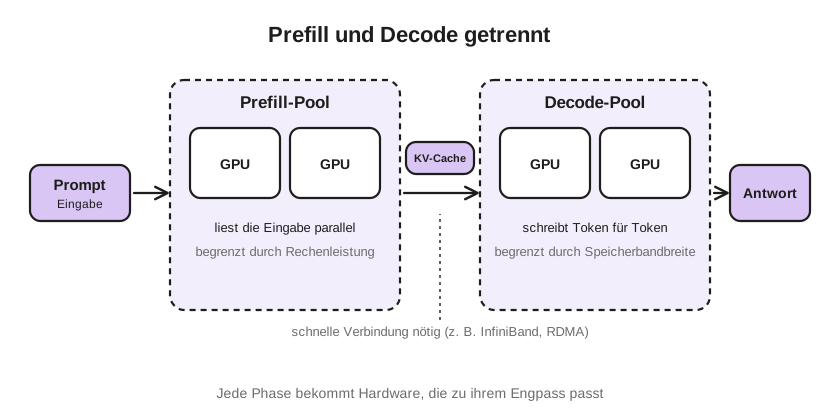
Die Trennung hat einen Preis. Der fertige KV-Cache muss vom Prefill-Pool in den Decode-Pool wandern, und das muss sehr schnell gehen. Mit gewöhnlichem Ethernet und TCP ist der Zeitgewinn meist wieder verspielt. Nötig sind spezialisierte Verbindungen wie InfiniBand oder RDMA-fähige Netzwerke.
In der Realität: alles gleichzeitig
Große Anbieter kombinieren diese Verfahren. Tensor-Parallelität innerhalb eines Servers, Pipeline-Parallelität über mehrere Server, Datenparallelität über mehrere Replikate, Expertenparallelität für MoE-Modelle und getrennte Pools für Prefill und Decode. Man spricht dann von mehrdimensionaler Parallelität.
Darüber liegt eine Orchestrierungsschicht. Sie leitet jede Anfrage an den passenden Pool, gleicht Last aus und fängt Hardwareausfälle ab, ohne dass Anfragen verloren gehen. Open-Source-Werkzeuge wie vLLM, SGLang oder llm-d bringen viele dieser Mechanismen inzwischen von Haus aus mit.
Was das für Ihre eigene KI-Infrastruktur bedeutet
Kaum ein Unternehmen im Mittelstand braucht einen Cluster mit Hunderten GPUs. Die Grundprobleme tauchen aber auch auf einem einzelnen Server mit zwei oder vier Karten auf. Daraus lassen sich ein paar Faustregeln ableiten:
- Zu viele Nutzer, Modell passt? Datenparallelität. Mehrere Kopien, ein Load Balancer davor.
- Modell passt nicht auf eine Karte? Zuerst prüfen, ob ein quantisiertes Modell genügt. Ein 70B-Modell in 4 Bit braucht rund 40 GB statt 140 GB. Erst danach auf Tensor-Parallelität innerhalb eines Servers setzen, und nur mit schneller Verbindung zwischen den GPUs.
- Lange Dokumente, viele gleichzeitige Gespräche? Den KV-Cache von Anfang an in die Speicherplanung einrechnen. Er wird regelmäßig unterschätzt.
Pipeline-Parallelität über mehrere Server, Expertenparallelität und getrennte Prefill-Decode-Pools sind dagegen Werkzeuge für sehr große Modelle und sehr hohe Last. Bevor Sie in diese Richtung investieren, lohnt eine ehrliche Bedarfsrechnung.
Interessiert? In einem kostenlosen Beratungsgespräch besprechen wir Ihre individuellem Anforderungen an den Einsatz künstlicher Intelligenz! Beratungstermin vereinbarenDie meisten Performance-Probleme bei lokaler KI sind Speicherprobleme. Wer Gewichte, KV-Cache und gleichzeitige Nutzer sauber durchrechnet, trifft bessere Hardware-Entscheidungen als jemand, der einfach die größte verfügbare Karte kauft.