


Nehmen wir an, Sie leiten die IT eines Personaldienstleisters mit 180 Beschäftigten. Die Geschäftsführung wünscht sich einen internen Assistenten, der Kundenverträge, Bewerberprofile und Einsatzpläne durchsucht und Fragen dazu beantwortet. Im Test des Prototyps fragt ein Disponent, ob eine Mitarbeiterin nächste Woche verfügbar ist, und die Antwort nennt nebenbei den Grund ihrer letzten Krankmeldung.
Gehackt wurde dabei nichts. Der Assistent hat gelesen, was über Fileserver und Postfächer für ihn erreichbar war, und dafür wenige Sekunden gebraucht. Mit dieser Beobachtung beginnt das Video Can Your AI Use Sensitive Data Safely? 5 Capabilities You Need von IBM Technology vom 3. November 2026: Über Jahrzehnte sind Kontrollen entstanden, die Menschen von sensiblen Daten fernhalten. Jetzt verarbeiten Maschinen diese Daten, also müssen die Kontrollen ebenso schnell arbeiten wie sie.
Die Daten, die einen Assistenten nützlich machen, sind oft dieselben, die am strengsten geschützt werden müssen: Kundendaten, Gesundheitsdaten, Finanzdaten. Ohne sie bleiben die Antworten allgemein. Data Governance für KI umfasst die Regeln und technischen Kontrollen, die festlegen, welche Daten ein KI-System lesen darf, wo sie verarbeitet werden, wer darüber Auskunft erhält und wie sich das belegen lässt. Das Video nennt dafür fünf Kontrollen. Dieser Beitrag ordnet sie für ein mittelständisches Unternehmen ein, das der Datenschutz-Grundverordnung (DSGVO) unterliegt.
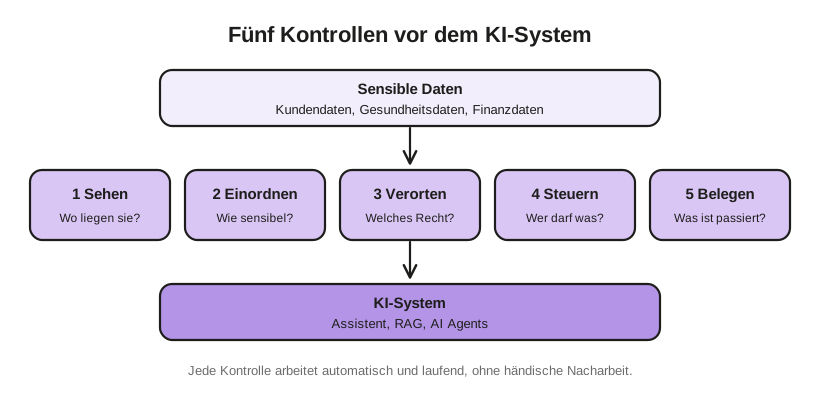
Sichtbarkeit und Klassifizierung: Was würde der Assistent lesen?
Den meisten Organisationen fehlt laut dem Video eine einheitliche Sicht darauf, wo ihre sensiblen und regulierten Daten liegen. Hinzu kommt, dass Daten wandern: vom eigenen Server in einen SaaS-Dienst, auf Notebooks, durch das Netzwerk.
Beim Personaldienstleister sieht das so aus: Bewerberprofile liegen im Bewerbermanagement eines Cloud-Anbieters, Lohnunterlagen auf dem Fileserver, Krankmeldungen als PDF im Postfach der Personalabteilung. Dazu kommen Excel-Exporte auf einzelnen Notebooks. Ein guter Startpunkt ist das Verzeichnis von Verarbeitungstätigkeiten nach Art. 30 DSGVO, das die Kategorien personenbezogener Daten sowie Übermittlungen in Drittländer aufführt. Die Ausnahme für Unternehmen unter 250 Beschäftigten greift hier nicht, weil Gesundheitsdaten verarbeitet werden. Für einen Assistenten brauchen Sie zusätzlich die Ebene darunter: welche Ablage, welches System, wer nutzt die Daten und wozu.
Erst die Klassifizierung nach Sensibilität zeigt, ob eine Schutzmaßnahme zum Wert der Daten passt. Zu viel Kontrolle sprengt das Budget und bremst Innovation, zu wenig führt zu Bußgeldern und kostet das Vertrauen der Kunden. Die DSGVO verlangt entsprechend in Art. 32 ein „dem Risiko angemessenes Schutzniveau“. Für den Anfang genügt ein Schema mit vier Stufen von „öffentlich“ bis „streng vertraulich“. Die Krankmeldung gehört in die höchste Stufe, weil Gesundheitsdaten zu den besonderen Kategorien nach Art. 9 DSGVO zählen. Lohndaten stehen dort nicht, vertraulich sind sie trotzdem.
Zwei Anforderungen wiegen bei KI schwerer als bei klassischer IT. Die Klassifizierung muss automatisch laufen, weil händisches Etikettieren langsam ist und Lücken lässt. Und sie muss stattfinden, bevor die Daten das KI-System erreichen. Bei einem Assistenten mit Retrieval-Augmented Generation (RAG) heißt das: Die Einstufung geschieht beim Einlesen, noch vor dem Vector Store. Was als streng vertraulich gilt, wird nicht indexiert, alles andere trägt seine Stufe als Metadatum mit.
Zugriff: Der Assistent weiß nie mehr als die fragende Person
Mit jedem KI-Projekt wächst die Zahl der Nutzer, Anwendungen und Modelle, die auf Daten zugreifen. Wer was darf, regelt das Identity and Access Management (IAM), das der Sprecher in vier A gliedert.
Administration legt Konten an und entfernt sie wieder, über einen Freigabeprozess und nach dem Prinzip Least Privilege: Jedes Konto bekommt nur die Rechte, die es braucht. Das gilt auch für das technische Konto, unter dem der Assistent Dokumente einliest. Authentication klärt, ob jemand ist, wer er zu sein behauptet, etwa mit Mehr-Faktor-Authentifizierung oder Passkeys. Authorization beantwortet die schwierigere Frage, ob diese Person eine bestimmte Aktion ausführen darf. Dafür gibt es rollenbasierte und an Bedingungen geknüpfte Zugriffsrechte. Das vierte A, Audit, prüft im Nachhinein, ob die ersten drei richtig umgesetzt wurden.
Für den Assistenten des Personaldienstleisters folgt daraus eine Bauregel. Die Suche im Vector Store filtert nach den Rechten der Person, die fragt, und erst die gefilterten Treffer gehen an das Modell. Der Disponent sieht dann Einsatzpläne und Qualifikationen. Ein Dokument der Personalabteilung erreicht ihn auch dann nicht, wenn es trotz Klassifizierung im Index gelandet ist. Für AI Agents, die Werkzeuge aufrufen, gilt Least Privilege ebenso. Wie Sie einen lokal betriebenen KI-Server absichern, zeigt unser Beitrag zu lokaler KI und Datenschutz.
Speicherort und Rechtsraum: drei Begriffe
Neben dem System, auf dem die Daten liegen, zählt in manchen Fällen auch dessen Standort. Drei Begriffe sind dabei auseinanderzuhalten.
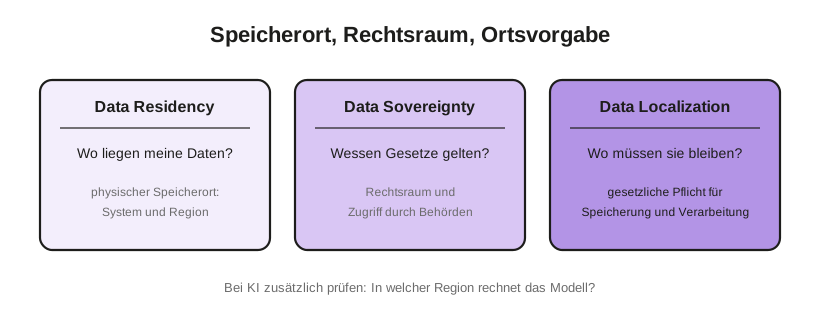
Data Residency (Datenresidenz) beschreibt, wo Daten physisch gespeichert sind, also auf welchem System und in welcher Region. Data Sovereignty (Datensouveränität) fragt, wessen Gesetze für diese Daten gelten und welche Behörde darauf zugreifen kann. Data Localization (Datenlokalisierung) ist die gesetzliche Vorgabe, bestimmte Daten innerhalb eines Landes oder einer Region zu speichern und zu verarbeiten.
Im Beispiel des Videos speichert ein US-Unternehmen Daten in einem deutschen Rechenzentrum und kann dadurch deutschem und europäischem Recht unterliegen. Für europäische Unternehmen ist die umgekehrte Richtung wichtiger, denn der Speicherort allein entscheidet nicht über die Geltung der DSGVO. Art. 3 DSGVO stellt auf die Niederlassung in der Union ab, „unabhängig davon, ob die Verarbeitung in der Union stattfindet“. Für den Personaldienstleister gilt die DSGVO also auch dann, wenn sein Assistent bei einem Anbieter außerhalb Europas rechnet. Die Übermittlung dorthin ist nach Art. 44 DSGVO nur unter den dort genannten Bedingungen zulässig.
Schwieriger wird es bei einem Rechenzentrum in Deutschland, das einem US-Konzern gehört. Der 2018 verabschiedete CLOUD Act stellt in 18 U.S.C. § 2713 klar, dass die Herausgabepflichten von Anbietern nach US-Recht auch für Daten gelten, die außerhalb der USA liegen. Wessen Recht sich dann durchsetzt, beantworten Juristen unterschiedlich. Stimmen Sie Ihren Ansatz deshalb mit Ihrer Rechtsberatung ab.
Bei KI kommt hinzu, dass Speicherort und Ort der Verarbeitung auseinanderfallen können. Ein Dokument kann in Frankfurt liegen, während das Sprachmodell, das es zusammenfasst, in einer anderen Region rechnet. In Cloud-Umgebungen ist das nicht immer als Metadatum sichtbar, fragen Sie Ihren Anbieter deshalb nach der Region der Inferenz. Läuft das Modell im eigenen Haus, sind Speicherort und Rechtsraum geklärt. Für welche Branchen sich das besonders lohnt, beschreibt unser Beitrag zur Datensouveränität mit lokaler KI.
Nachweis: Protokolle, die niemand ändern kann
Prüfer und Aufsichtsbehörden wollen Belege sehen. In der DSGVO heißt das Rechenschaftspflicht: Der Verantwortliche muss nach Art. 5 Abs. 2 die Einhaltung der Grundsätze „nachweisen können“.
Das Video beschreibt dafür eine Kette aus vier Schritten. Datenbewegungen werden automatisch protokolliert und als unveränderlicher Audit Trail gespeichert, weil ein nachträglich änderbares Protokoll nichts beweist. Anschließend werten Sie die Aufzeichnungen aus und legen sie Prüfern vor. Die Prüfer wollen wissen, wo die Daten liegen, wer darauf zugegriffen hat, was damit geschah und welches KI-System sie verwendet hat.
Die letzte Frage ist mit KI neu hinzugekommen. Für den Assistenten heißt das: Zu jeder Anfrage wird festgehalten, wer gefragt hat, welche Dokumente mit welcher Klassifizierung an das Modell gingen und welches Modell geantwortet hat. Das Video rät ausdrücklich davon ab, Datenbewegungen erst im Nachhinein von Hand zu rekonstruieren.
Womit Sie anfangen
Bevor der erste Assistent startet, müssen die fünf Kontrollen nur für die Daten stehen, die er lesen soll. Wählen Sie einen abgegrenzten Bestand, etwa Kundenverträge und Einsatzpläne, und beantworten Sie für ihn fünf Fragen:
- Wo liegen diese Daten, und wohin werden sie kopiert?
- Welche Schutzstufe hat jedes Dokument, und wer vergibt sie automatisch?
- In welchem Land wird gespeichert, in welchem gerechnet, und welches Recht gilt für den Anbieter?
- Filtert die Suche nach den Rechten der fragenden Person?
- Lässt sich für jede Antwort belegen, welche Dokumente das Modell gesehen hat?
Der Personaldienstleister aus dem Beispiel hätte seinen Vorfall mit der zweiten und der vierten Frage verhindert. Sind alle fünf beantwortet, können Sie den Bestand schrittweise erweitern.
Häufige Fragen zu sensiblen Daten in KI-Systemen
Welche Daten gelten für KI-Systeme als sensibel? Im Datenschutzrecht sind es vor allem personenbezogene Daten und die besonderen Kategorien nach Art. 9 DSGVO, zu denen Gesundheitsdaten gehören. Für Unternehmen kommen Finanzdaten, Verträge und Geschäftsgeheimnisse hinzu.
Was ist der Unterschied zwischen Data Residency und Data Sovereignty? Data Residency beschreibt den physischen Speicherort der Daten. Data Sovereignty fragt, wessen Gesetze für sie gelten. Beides kann auseinanderfallen, etwa bei einem Rechenzentrum in der EU, das einem US-Anbieter gehört.
Reicht ein lokales Sprachmodell als Schutz aus? Ein lokales Modell klärt Speicherort und Rechtsraum. Klassifizierung, Zugriffsrechte und Protokollierung brauchen Sie auch dort, denn ein Assistent im eigenen Haus kann interne Daten ebenso an die falsche Person ausgeben.
Interessiert? In einem kostenlosen Beratungsgespräch besprechen wir Ihre individuellem Anforderungen an den Einsatz künstlicher Intelligenz! Beratungstermin vereinbaren